

科学多模态大模型书生-S2.1 Flash上线,多快好省做科研
来源:上海人工智能实验室| 2026-11-16
近日,上海AI实验室发布并开源书生科学多模态大模型 S2.1 Flash(简称书生-S2.1 Flash)。模型融合实验室近期一系列前沿原创技术,在科学数据理解、复杂科研任务闭环执行能力上实现进阶,且同一任务下其推理成本仅为智能体模型书生·星河的十分之一,让科研工作提质、提速、提效,实现多快好省。
科研任务通常需要多轮分析与反复验证。为此,书生-S2.1 Flash依托书生·元征(Sage·SciPerception)的统一表征架构,可支持分子、光谱、生物序列等多类专业数据输入;融合科学多模态理解与通用智能体能力,实现依托视觉感知操控科研软件,让大模型直接参与科研实操。
实验室在递归式自我改进(RSI)方面的前期探索,也已应用至书生-S2.1 Flash。模型可在多轮任务闭环中持续迭代优化,形成面向科研场景的自进化飞轮。
书生-S2.1 Flash的闭环科研执行能力已在多个场景得到验证。本文通过CT切片序恢复与三维骨骼重建、鄱阳湖遥感水域变化量化、航空发动机装配建模检查、脑电伪迹自动剔除等四项任务,直观展示该模型从理解输入、使用工具到核验结果的执行过程。
书生-S2.1 Flash已上线书生·端砚科学发现平台,欢迎全球开发者与科研人员体验。
体验链接:https://discovery.intern-ai.org.cn/token-plan/home
ModelScope:https://www.modelscope.cn/models/Shanghai_AI_Laboratory/Sage-S2.1-Flash
Huggingface:https://huggingface.co/internlm/Sage-S2.1-Flash
技术报告:https://github.com/InternLM/Sage-S2.1-Flash/blob/main/sage_s2.1_tech_report.pdf
前沿通用智能体能力:构建复杂科研任务的执行基础
复杂科研任务要求模型围绕同一研究目标,综合运用检索、编程和工具调用能力。以科研数据分析为例,模型需要查阅资料,确认测量方法与样本范围,再编写代码、调用专业工具完成计算。若结果出现异常,还需回查原始数据和处理代码,定位问题并调整分析步骤。
书生-S2.1 Flash将多模态理解、分析推理、编程与工具调用相结合,能够综合分析多种形式的信息,自主规划任务步骤、协调使用异构工具,推进复杂任务从问题分析到成果交付的全过程。
专业评测验证了书生-S2.1 Flash的通用能力。科研团队横向对比五款主流模型,设置十五项通用智能体基准,覆盖代码工程、文档解析、表格处理、网页交互、系统操控、深度调研等丰富任务类型。书生-S2.1 Flash在四项基准中夺得第一,表现优于Claude Opus 5、DeepSeek-V4.1 Flash、GLM-5.3-Flash等前沿模型,涵盖机器学习工程、复杂办公文档、专业法律文书与电子表格分析;另有七项基准位居第二,其余任务同样表现亮眼。综合结果印证,模型具备均衡强劲的通用智能体能力,为面向复杂科研任务的智能体应用筑牢基础。
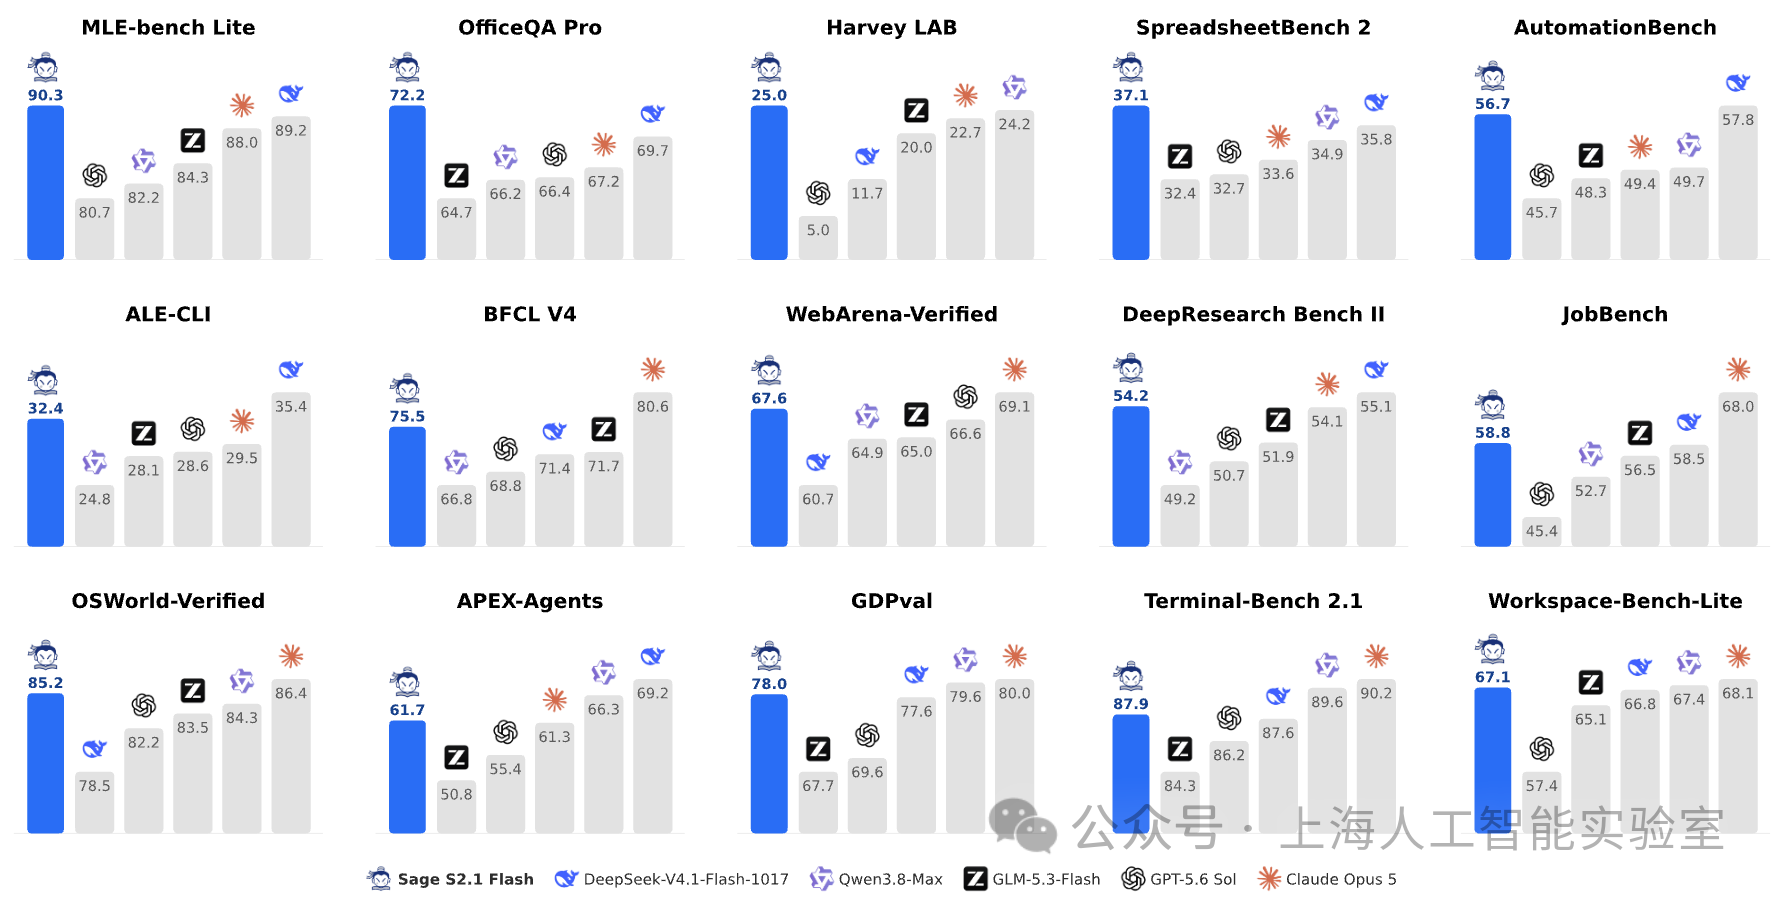
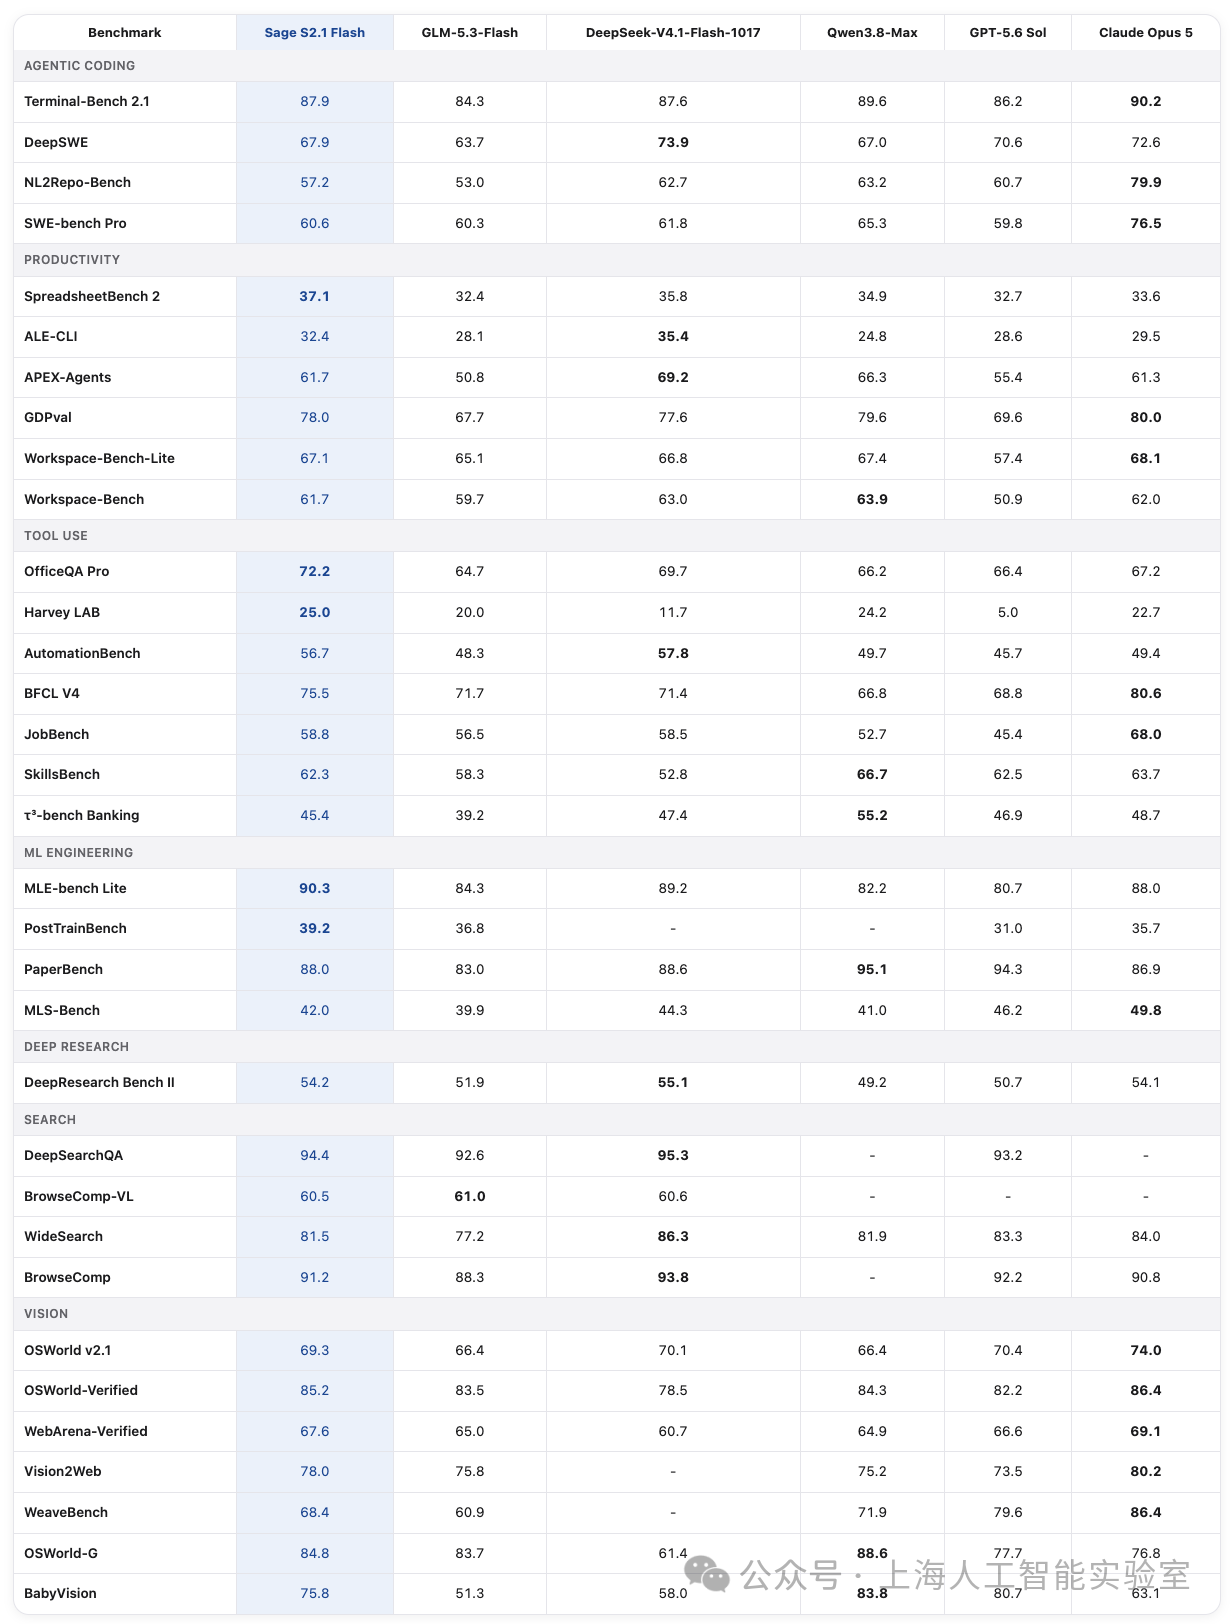
通用智能体能力测评榜单
科学多模态统一表征,RSI助力自主进化
通用语言能力不足以直接解读科学数据。模型读懂问题只是起点,更要捕捉谱峰、生物序列、空间结构当中的精细科学线索,才能更好地完成各类科学推理任务。
在书生·元征的助力下,书生-S2.1 Flash能将分子图、晶体结构、蛋白质序列与三维结构,DNA、RNA序列,以及光谱、质谱、X射线衍射、心电、脑电和光变曲线等科学数据转换为语言大模型可识别的表征,让科学数据与自然语言提问共同进入模型推理链路。上述输入覆盖物质结构、生物序列与实验观测等不同类型的科学数据,书生-S2.1 Flash将形式迥异、领域跨度巨大的科学信息得以汇聚到同一个共享表征空间,实现跨模态科学信息的互通与联合理解。
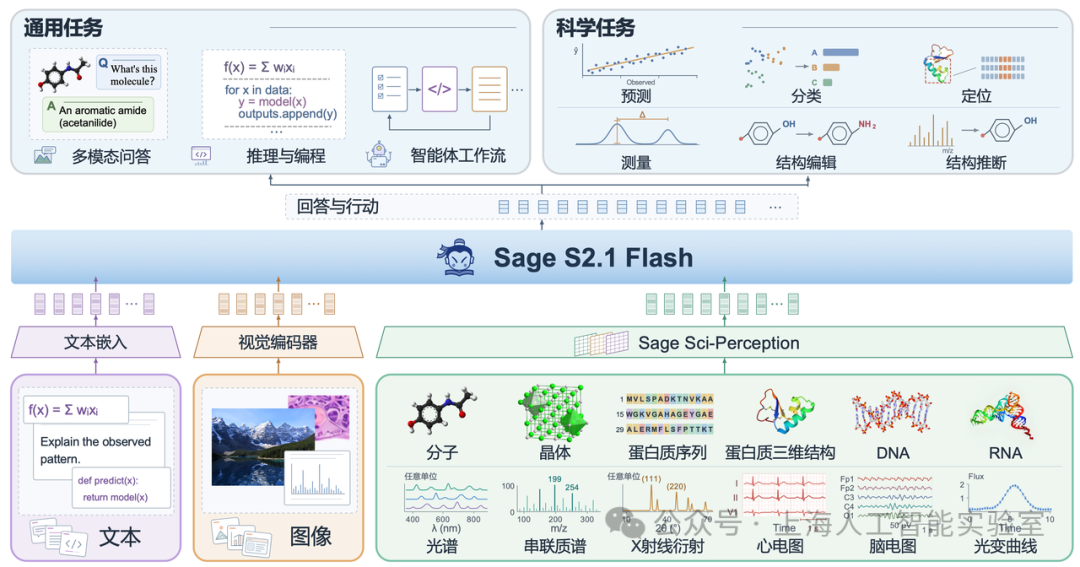
科学多模态统一表征架构
此外,书生-S2.1 Flash也将沿用书生·元征的递归式自我改进(RSI)模式。RSI能助力模型从真实科研任务的执行轨迹、工具返回结果与人工核验反馈当中持续汲取信号,形成自进化飞轮,让模型在反复处理科学多模态输入、调用科研软件、校验实验结论的过程中不断修正推理偏好,逐步提升复杂科研任务的规划、数据分析与结果自核验水平,为科研智能体的长期演进提供支撑。
视觉驱动的复杂科研执行:在专业软件中验证结果、调整行动
复杂科研任务讲究动态决策,模型需要依据实时产出的中间结果,自主规划后续动作。书生-S2.1 Flash能够在各类专业科研软件内开展分析与建模,读取原始切片、遥感影像、装配视图、脑电波形等可视化信息,核验分析产出,并据此迭代分析思路、调整操作流程。
实例一:从1.2万余张混杂CT图像中还原切片层序,重建三维骨骼
面对来源混杂、顺序打乱且朝向不一的CT图像,书生-S2.1 Flash先校正图像朝向,再依据图像特征,从1.2万余张图像中筛出属于同一次扫描的139张切片。首轮排序未能通过一致性校验时,模型自动切换方案,分区还原切片顺序再拼接融合,得到连贯完整的层序。随后它调用3D Slicer借助密度阈值分割骨性区域,重建三维骨骼。在研判脊柱与肋骨的空间构型时,模型多角度检视重建模型,针对局部骨性突起回溯相邻原始切面,并把核验后的观测结论写入报告。
实例二:对照两期卫星影像,量化鄱阳湖水域变化
书生-S2.1 Flash在QGIS中对照两期鄱阳湖卫星影像,定位湖岸变化显著区域,依托多光谱信息圈定候选水域。为校验边界精度,模型将提取图层叠加至原始彩色影像,重点甄别浅水与滩涂交界,按需调整提取规则。为保证跨期面积具备可比性,模型将统计范围限定在两期影像共同有效的研究区内,测算水域增减,输出变化分布图、面积统计表以及完整QGIS工程。科研人员可直接打开这份工程,沿着湖岸回溯原始影像,核验面积测算的全部依据。
实例三:面向可制造性评估,完成航空发动机建模与装配检查
书生-S2.1 Flash从参考图中识别发动机的总体构型、外部轮廓与零件布局,梳理各零件的相对尺寸和装配关系,并在CAD环境中完成参数化建模与整机装配。装配完成后,模型自动开展全局干涉检查并完成修复,最终输出的可编辑CAD模型与渲染图,方便工程师复核零件位置、装配关系与整体方案,支撑可制造性评估与后续设计迭代。
实例四:识别脑电信号中的眨眼伪迹,复核去除效果
针对存在明显扰动的实测脑电数据,书生-S2.1 Flash在EEGLAB中检视原始波形,结合独立成分时序、头皮空间分布与频谱特征,定位眨眼诱发的伪迹并剔除对应成分。为检验处理效果,模型在同一时间窗、同一幅值尺度下叠放处理前后的波形,确认目标片段伪迹抑制效果,并延伸抽检其余时段。全套成果包含净化后的信号、剔除成分清单以及波形对比图,便于研究者追溯判别逻辑,复核信号处理质量。
一项科研分析是否可靠,关键在于能否被复核、修正,并在此基础上持续推进。书生-S2.1 Flash 在处理科学数据、使用专业软件的过程中,根据中间结果调整方法,并交付可重新打开的工程文件、可回查的原始数据和可核对的处理记录。研究者顺着这条证据链,即可检验模型判断、修改分析参数,启动新一轮验证,让智能体真正成为科研工作里可信赖的协作伙伴。
未来,上海AI实验室还将继续沿着通专融合技术路径,持续迭代书生系列大模型,打造赋能科学智能的高原,助力全球科研人员攀登科学发现的“珠穆朗玛”。