

大模型自主设计“科学感官”,多模态框架书生·元征以RSI拓展大模型能力边界
来源:上海人工智能实验室| 2026-11-06
科学智能持续向前演进。上海AI实验室正立足通专融合战略路径,搭建科学感知通路、释放模型自进化潜力,推动通用人工智能更好地服务前沿科学探索。
近日,上海AI实验室推出科学多模态框架书生·元征(Sage SciPerception)。该框架依托可训练投影模块,将谱图、序列、晶体结构和时序信号等科学特征转换为语言大模型可识别的表征,让科学数据与自然语言提问共同进入模型推理链路;同时引入递归式自我改进(RSI)模式,支持模型自主探索并优化感知架构,为大模型建立面向真实科研场景的原生感知通道。
作为实验室“SAGE”通专融合技术架构中基础模型层的新进展,书生·元征在持续增强模型专业感知能力的同时,保全其通用能力。评测显示,在书生·元征的助力下,书生科学多模态大模型S2(书生-S2)显著提升蛋白关键位点定位、晶体物性预测、多光谱分子识别能力。
接下来,书生·元征将用于下一代书生‑S系列科学模型,以通专融合推动领域专长与通用推理深度耦合;该框架还将继续接入新模型、新数据、新工具,在更多真实科研场景淬炼架构自迭代能力,助力更多科学原创突破。
GitHub:
https://github.com/InternLM/Sage-SciPerception
Hugging Face:
https://huggingface.co/internlm/Sage-SciPerception
引入RSI模式,让模型参与设计模型
区别于常见的人工反复设计、逐项调试的开发方式,书生·元征在整体训练中引入了RSI模式,赋予模型自主设计的能力。依托这套框架,模型能参与分析任务表现、识别架构短板并提出新的投影模块方案,再经由训练与评测验证方案优劣,启动新一轮迭代循环。模型不再仅仅学习如何完成科学任务,还可以参与科学感知架构本身的优化。
这套机制带来范式层面的转变。面向跨学科的多样数据,研发不再需要为每一类模态单独定制固定接口,而是建立起提出架构、训练验证、复盘分析、持续优化的完整闭环。模型围绕具体任务自主探索科学特征的组织方式、语言空间对齐策略以及适配数据的投影结构。RSI将迭代边界从数据与能力拓展至架构本身,为科学大模型持续接入新模态、新任务开辟出新的技术路径。
书生-S2在非编码RNA家族分类任务上的实践,正是这套能力的落地案例。起初,书生-S2尝试引入分类监督和全局注意力,以期增强科学特征的任务适配与交互能力;验证未见收益后,它主动终止该方向探索,重新审视优化思路:科学特征可能已经包含足够的分类信息,瓶颈可能存在于特征向语言底座传递的环节。以此为基础,智能体设计分阶段读出方案,先训练科学分类器,再单独学习其到冻结语言底座的映射,将测试准确率从90.04%提高至94.65%。后续迭代融入编码器适配与独立投影侧路,进一步将准确率提升至96.73%。整个过程直观展现,借助书生·元征,模型能够依托实验反馈修正设计假设,自主推进研发迭代。
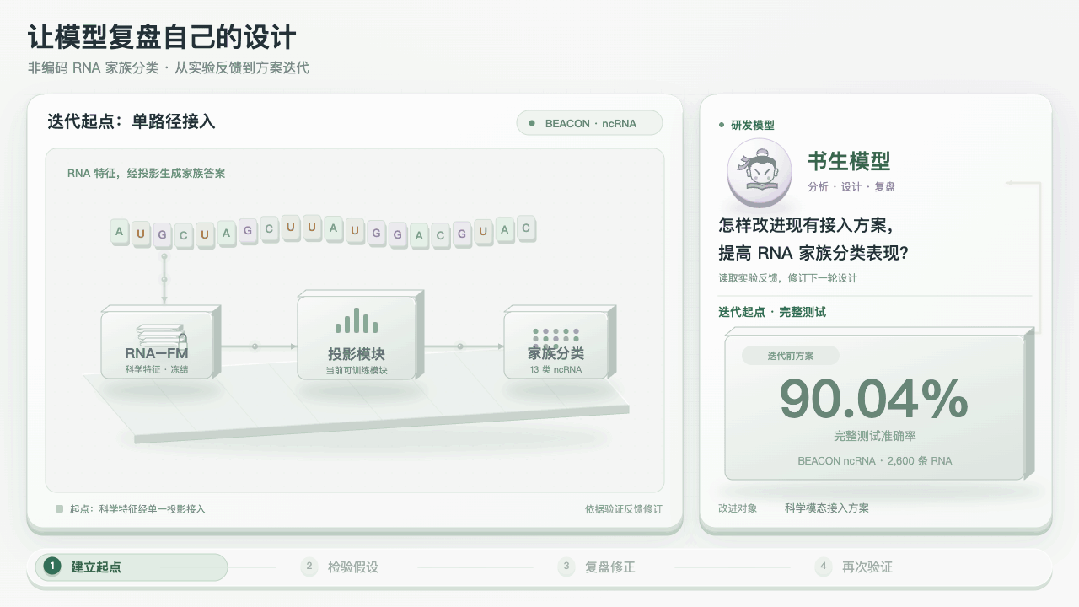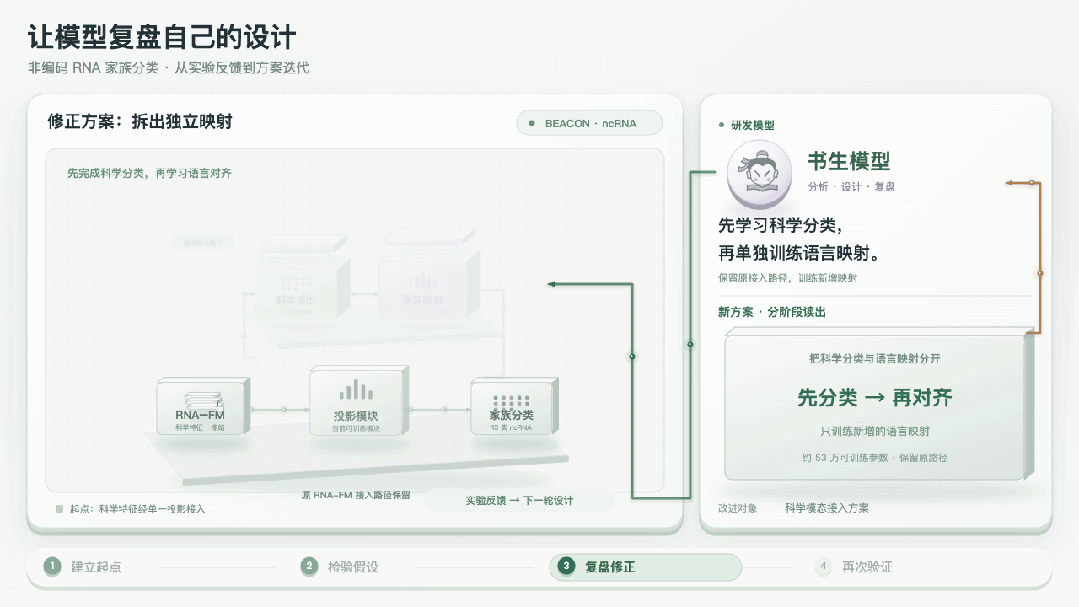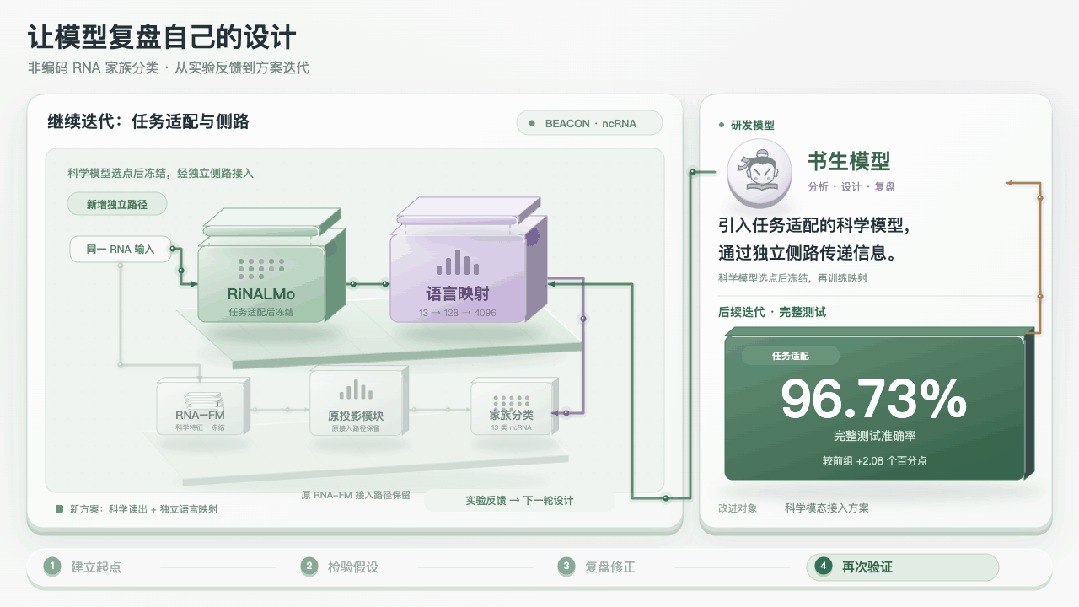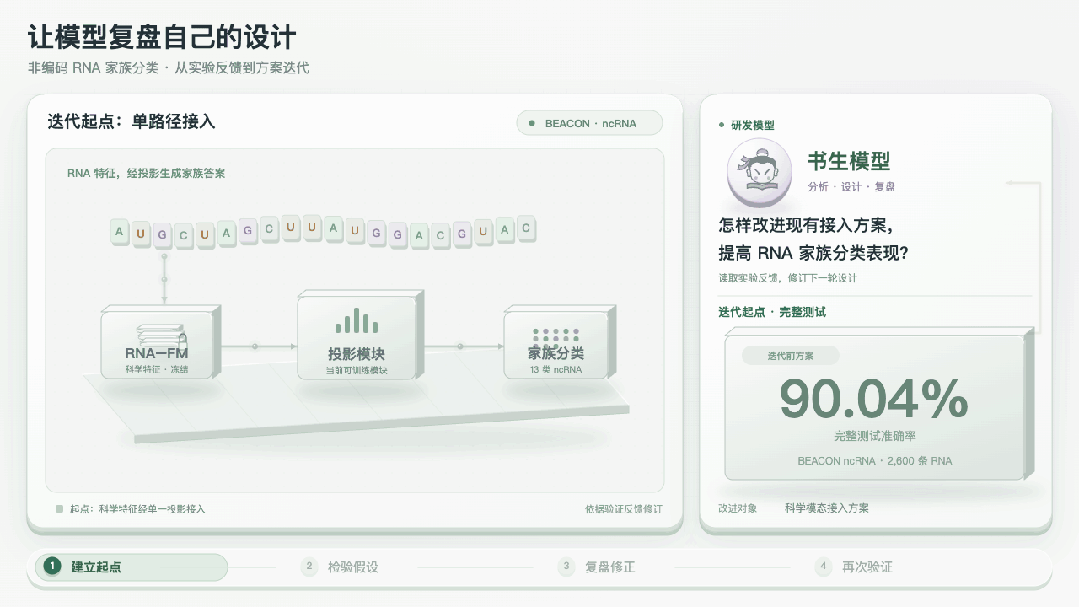
书生-S2在非编码RNA家族分类任务上的实践,正是这套能力的落地案例
底座模型固定,以轻量化投影实现高效科学感知
在架构层面,书生·元征采用冻结底座模型,只训练转换接口的轻量化方案。以支持ncRNA读出映射实验为例,仅更新约0.0005B参数,即可将科学表征接入冻结语言模型。调用科学编码器时,领域编码器与通用语言底座参数保持固定,仅训练衔接二者的投影模块;针对谱图这类任务,数值观测数据也可直接送入投影模块。这套方案将参数学习聚焦于科学特征与语言空间的对齐,充分复用领域模型沉淀的专业表征,同时最大限度保留语言大模型原生的指令理解与文本生成能力。
领域科学编码器提取原子、残基、晶格、信号片段等精细科研信息,再由投影模块完成特征向语言空间的映射。进入推理阶段,转换后的科学特征与研究者的自然语言问题一同输入语言模型,输出分类结果、关键位点、分子结构、物性参数等科研答案。
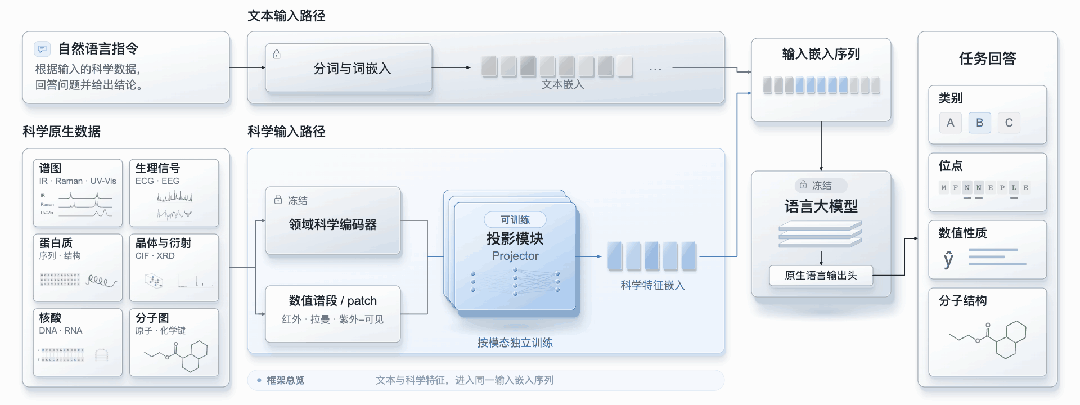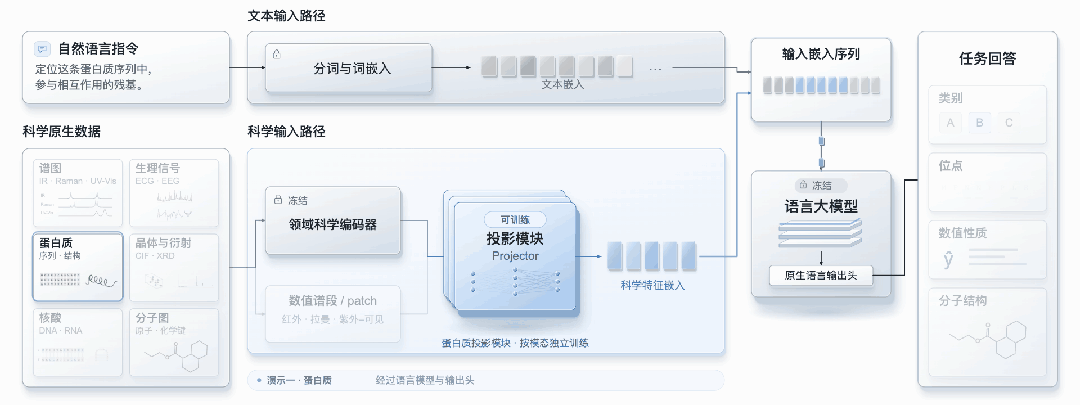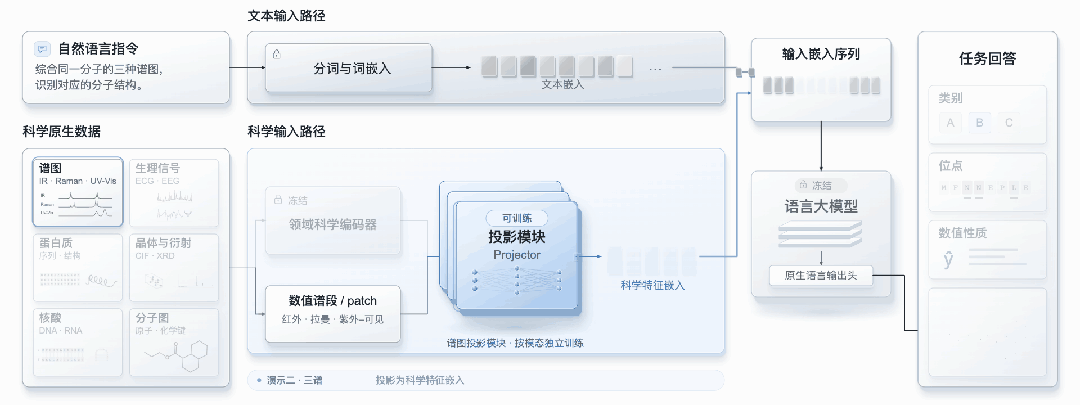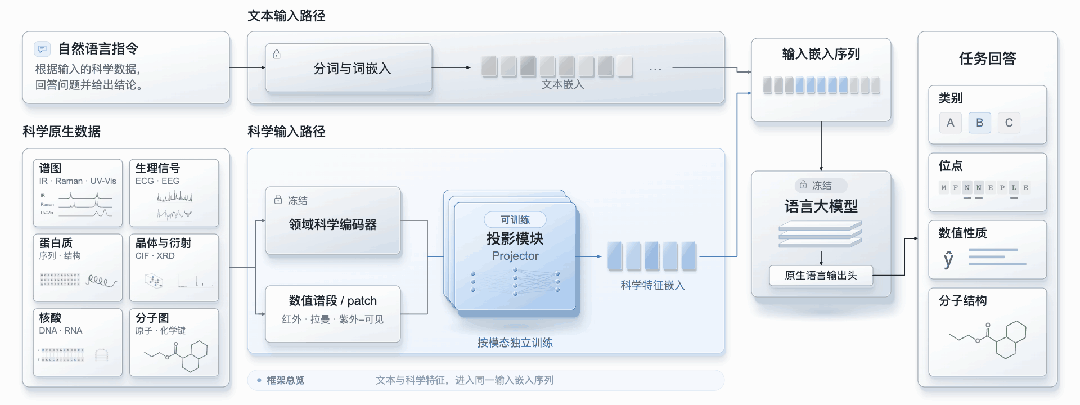
书生·元征架构:以投影模块连接科学原生数据与语言大模型
基于这一创新架构,书生·元征融合人类专家及通用语言模型两者优势。框架以原子、残基、晶格、信号片段为细粒度单元组织特征,依靠投影模块直连语言模型输入空间,规避冗长数值文本带来的开销;复用成熟领域表征,结合模型思维链(CoT)生成能力,同步输出结论、推理过程与结构化结果,便于研究者核验。以一段12导联、时长9秒、采样率500Hz的心电信号为例,若将全部观测数值逐项转为文本,约需25.3万个输入Token;依托书生·科学通感,输入仅为452个Token,输入长度减少约99.8%,体现了科学特征接入在处理高维观测数据时的紧凑性。
面向多类科研任务的科学感知能力验证
通用语言能力不足以直接解读科学数据。模型读懂问题只是起点,更要捕捉谱峰、生物序列、空间结构当中的精细科学线索。依托面向不同任务定制的科学表征与投影接口,书生·元征把这类专属科学信息送入冻结的语言底座,融合领域模型的特征提取能力与语言模型的指令推理能力,更好地完成各类科学推理任务。
目前,书生·元征已在谱图理解、心电分类等十类科学模态任务上完成训练和完整测试集评估,在结构识别、信号分类、位点定位和性质预测等任务上展现了有竞争力的表现。例如,在晶体形成能预测基准JARVIS-DFT上,书生·元征取得15.03的MAD/MAE得分;在非编码RNA家族分类基准BEACON ncRNA上,其准确率达到97.35%,在同类基准上实现性能提升。
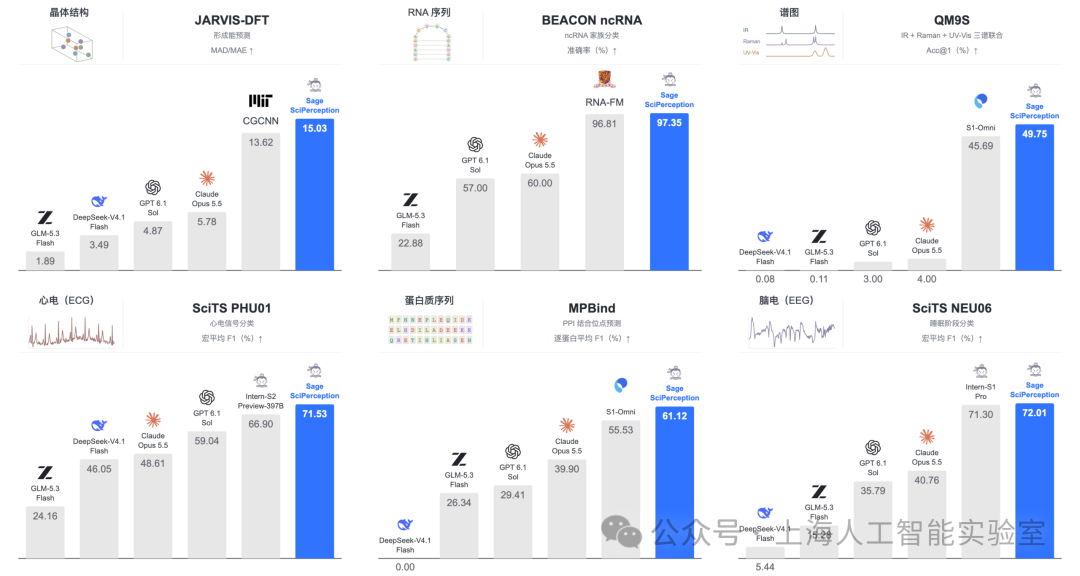
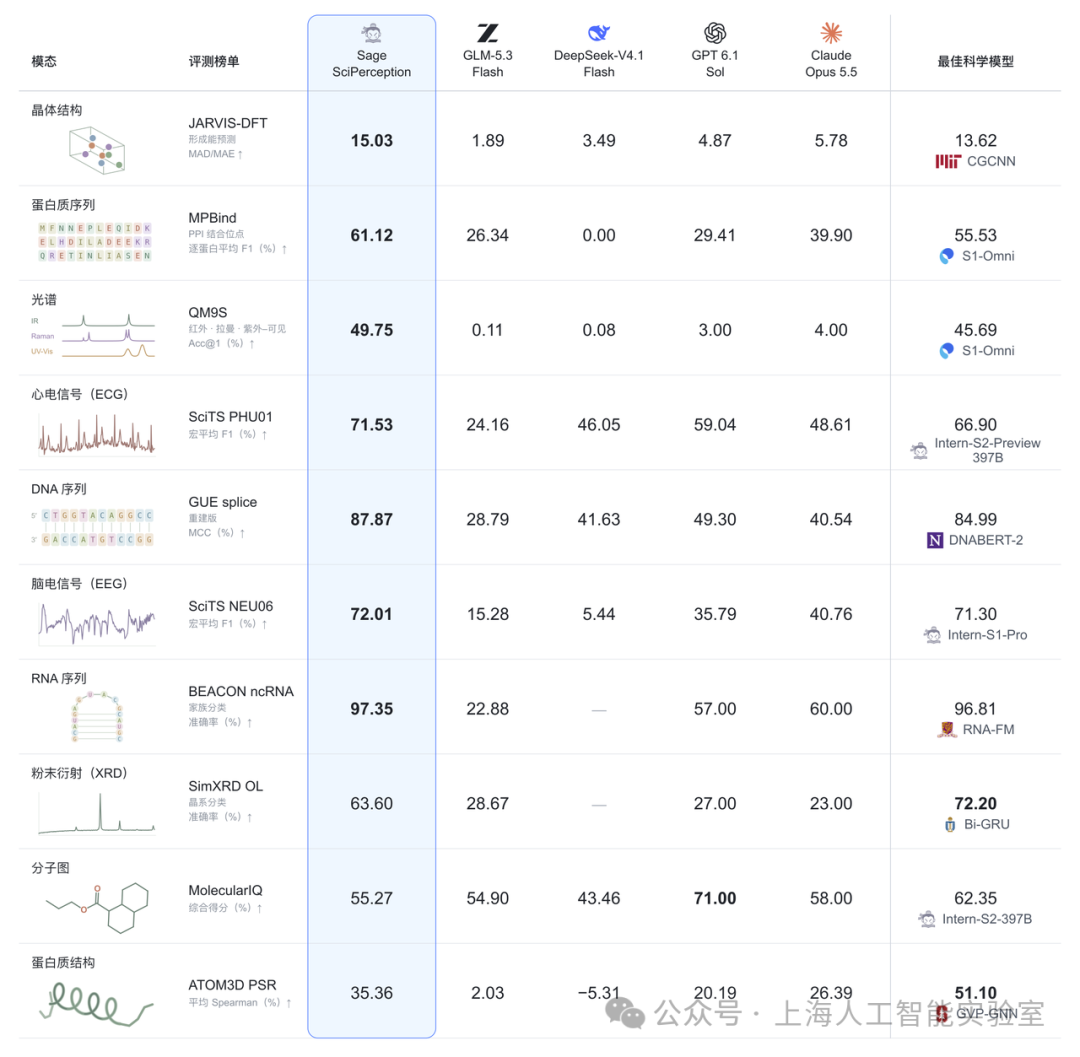
十类科学模态任务评测
在蛋白质序列中定位关键位点
蛋白质互作用是大多数生命活动的基础,定位它们的接触位置,是解析蛋白结合机制的核心环节。但一条由数百个氨基酸组成的蛋白质,究竟会用哪些位置与其他分子相互作用?
依托书生·元征,模型可以结合蛋白质专属科学表征,预测可能参与相互作用的残基,并给出对应的序列位置。在MPBind位点识别评测中,逐蛋白平均F1达到61.12%,高于相同测试集上复现的S1-Omni的55.53%。这些残基级别的候选位点,能够为后续互作分析和位点突变实验提供验证目标,打通模型预测与科研实验。
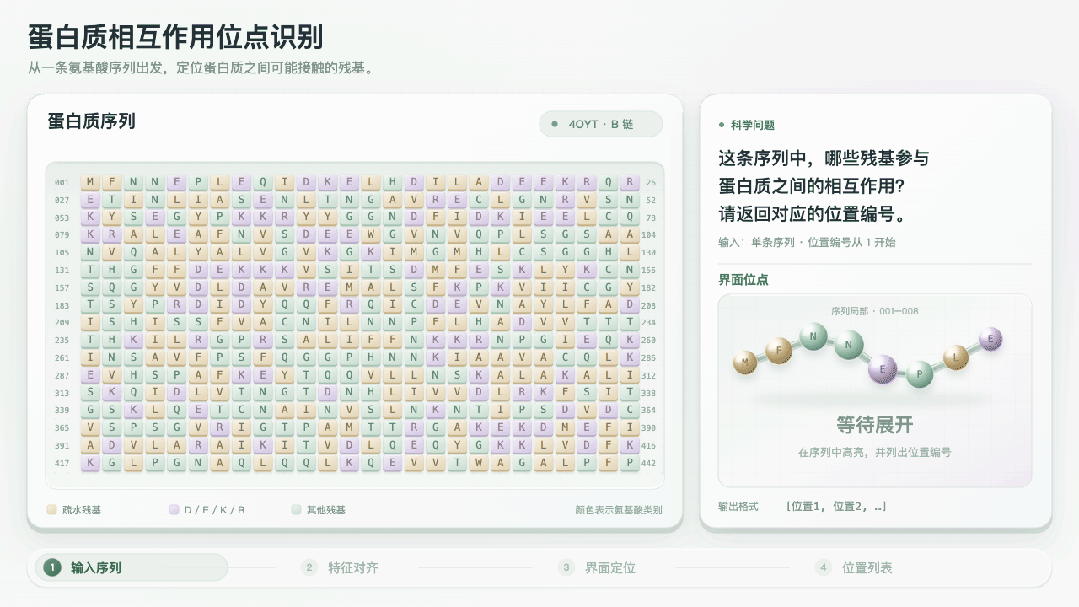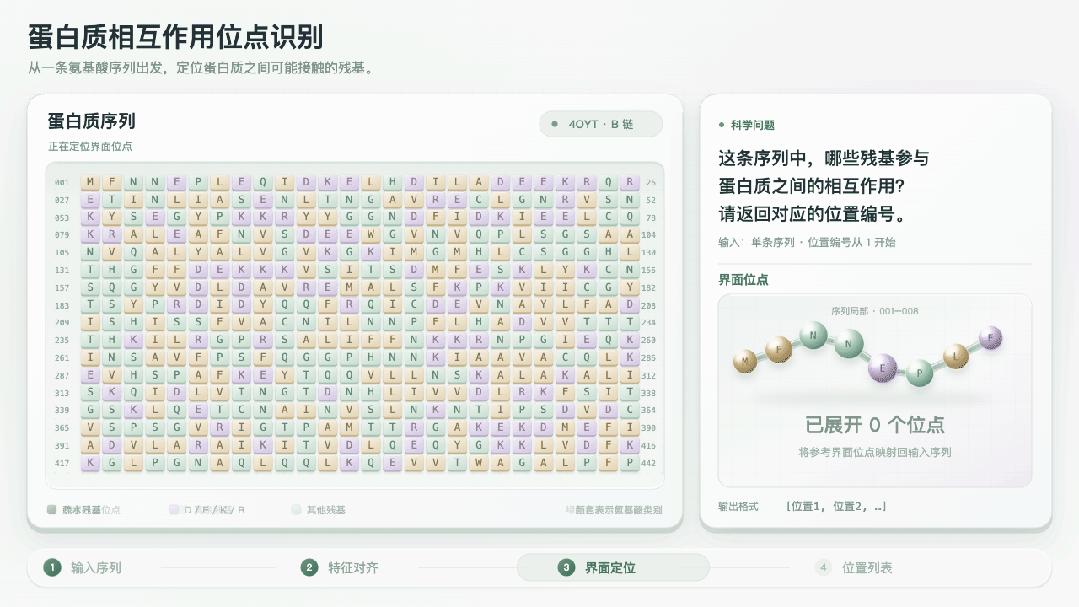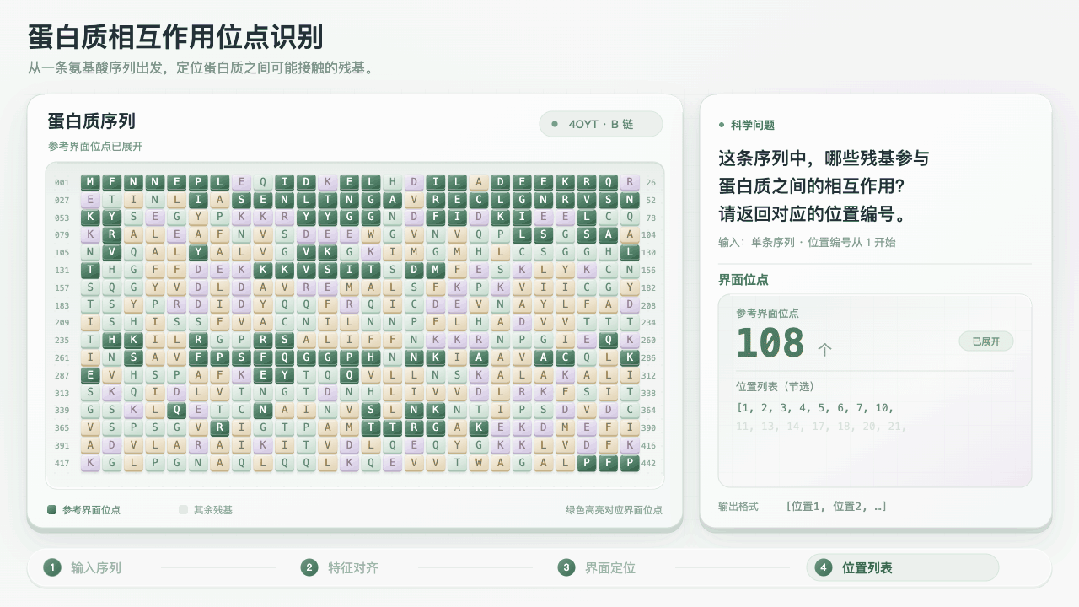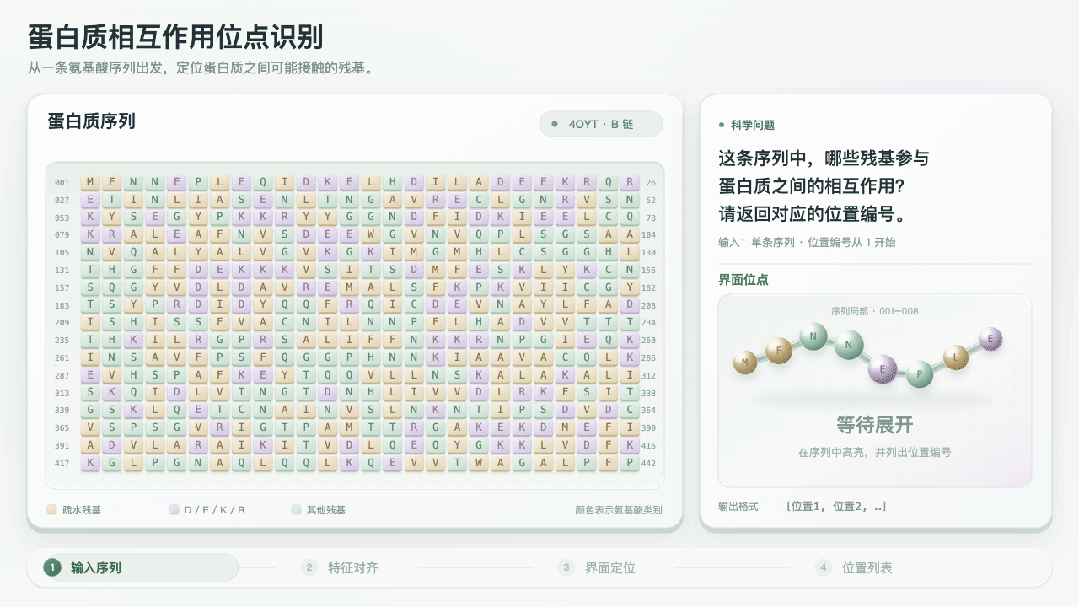
蛋白质相互作用位点识别任务演示
从三维晶体结构预测材料性质
料性能由元素组分与原子三维排布共同决定,原子的空间排列、局部配位环境,深刻影响晶体的能量特征。依托书生·元征,研究者可以针对晶体结构发起自然语言查询;模型综合元素构成、周期性晶格与局部配位信息,预测原子尺度的形成能,给出可量化的能量分析结果。
在JARVIS-DFT形成能预测评测中,其MAD/MAE得分达到15.03,高于麻省理工学院团队提出的CGCNN模型的文献参考成绩13.62。依托这套能力,科研人员可以直接对目标材料开展问询,获取可供核验的性质预测,为候选材料筛选与后续计算验证提供支撑。
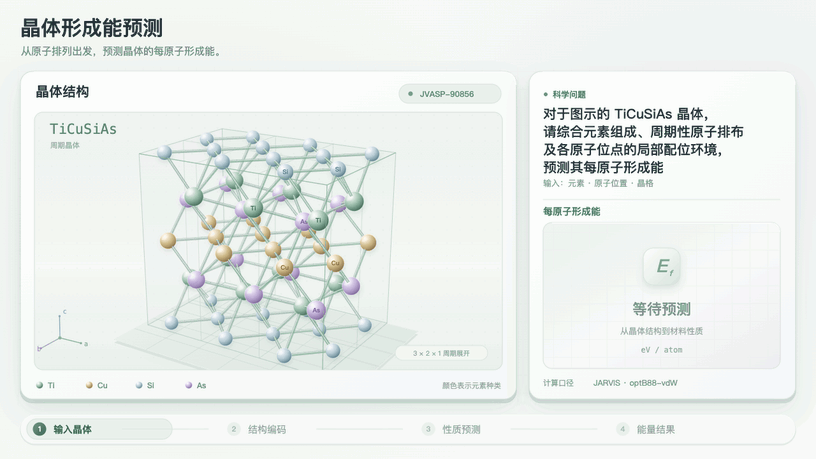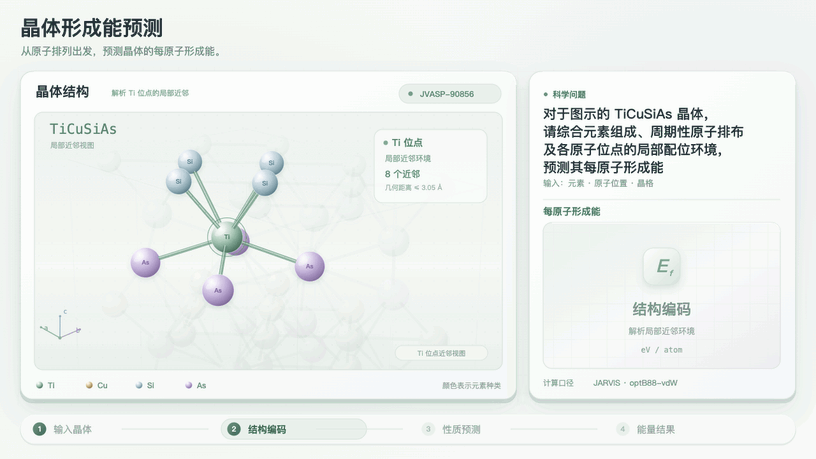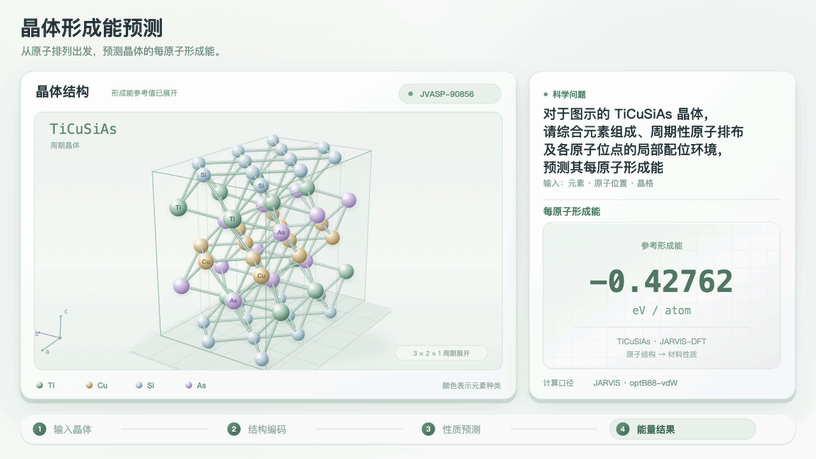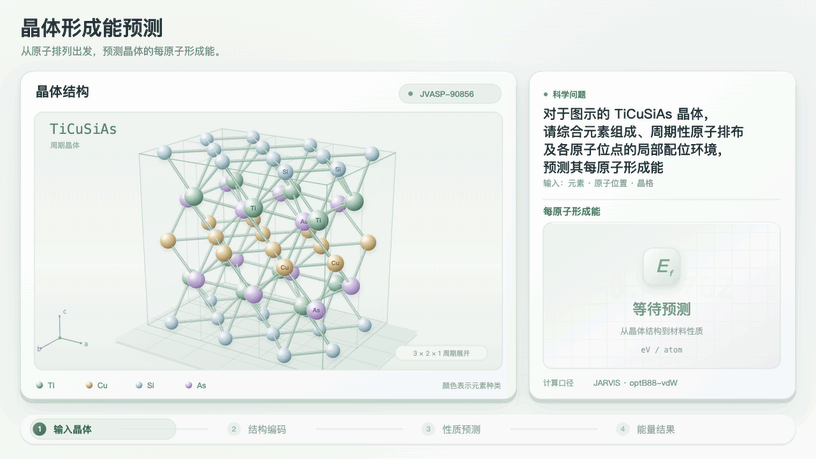
晶体能形成预测任务演示
联合三种光谱识别分子结构
分子光谱是识别化学结构的关键。书生·元征可以同步接纳多组光谱信号,借助思维链开展分步推理,再输出候选分子结构,完整呈现模型整合光谱信息、推导出结构假设的过程。
在测试样例中,模型依次提出关键结构线索,再结合题目给定的原子总数核对分子组成,最终生成候选结构。在QM9S三谱联合识别的完整测试集上,其首选结构命中率(Acc@1)达到49.75%,高于S1-Omni的45.69%和DiffSpectra的40.56%文献参考成绩。思维链推理留下清晰可追溯的分析路径,研究者能够直观看到模型捕捉到的化学线索、采纳的约束条件,方便核验结构假设是否合理。
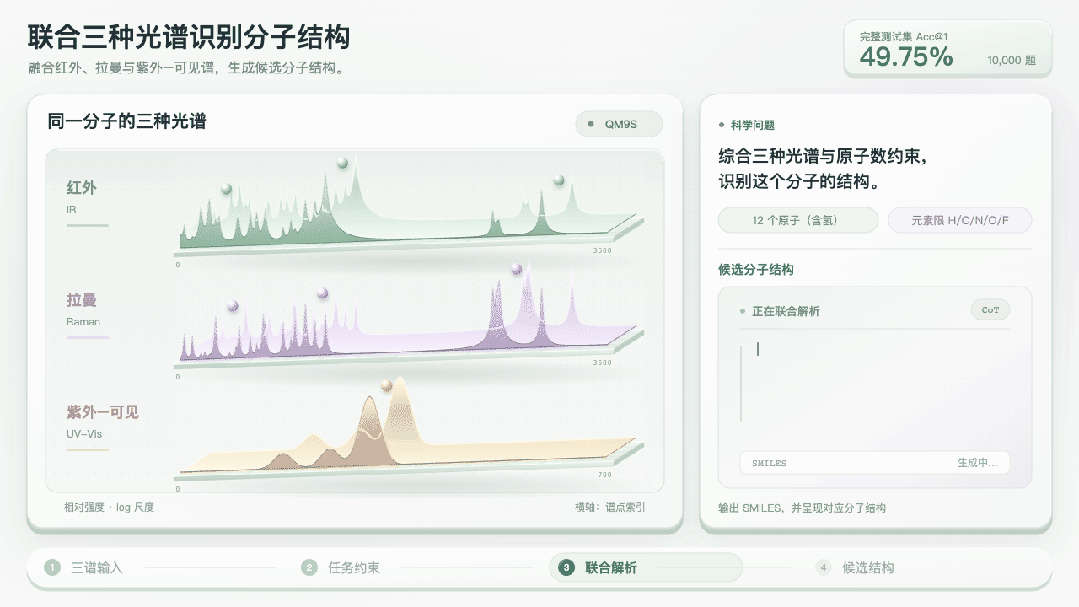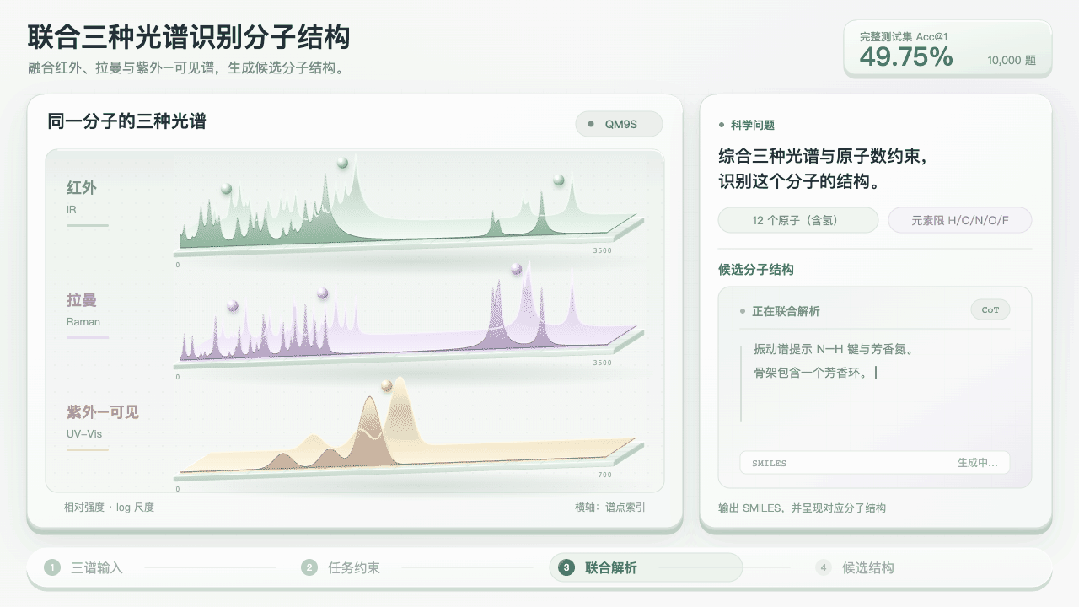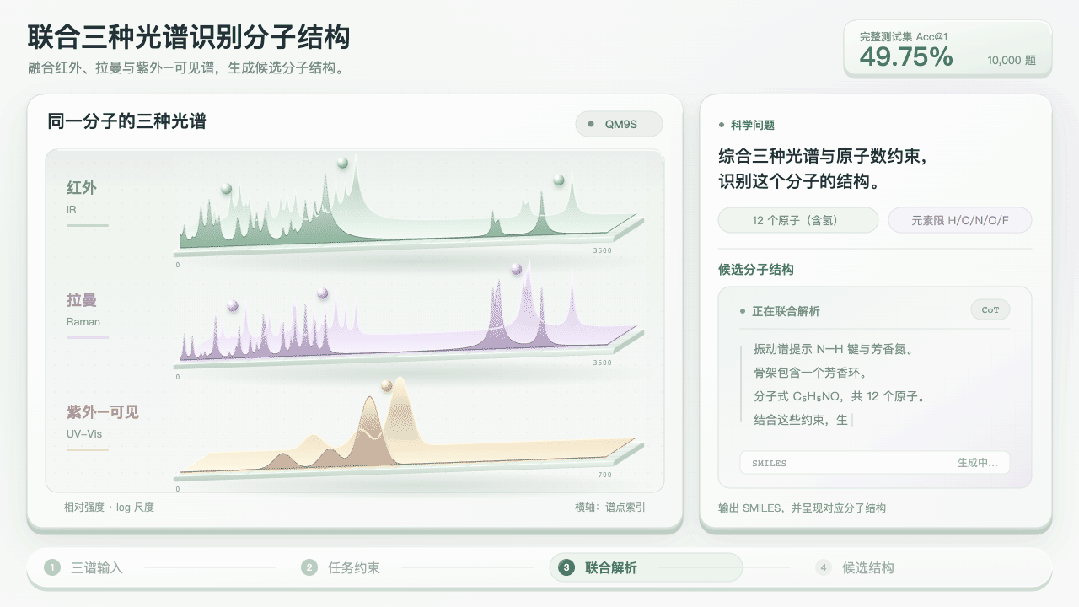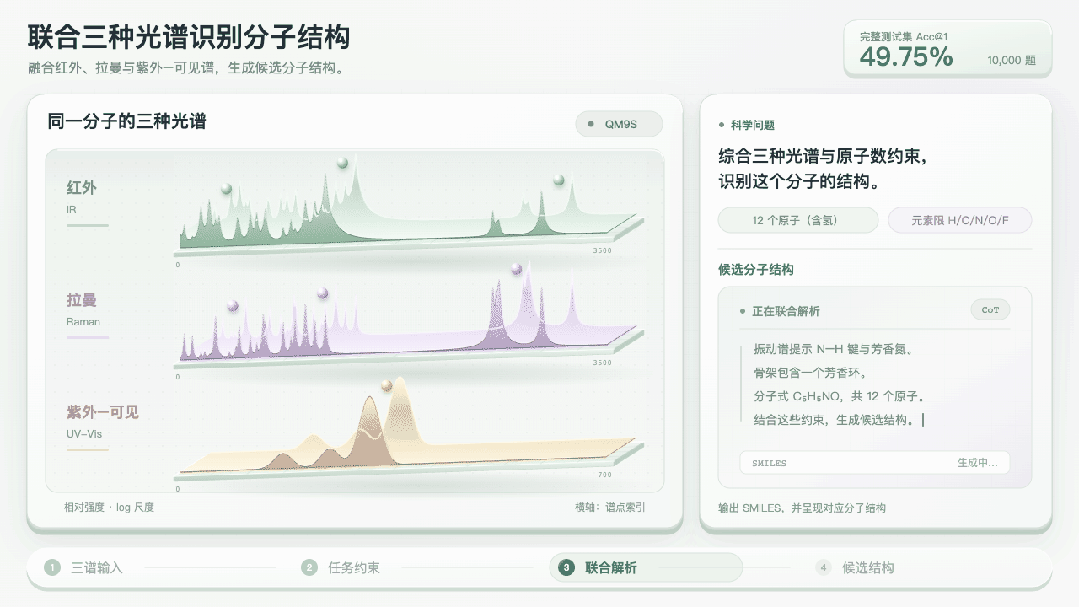
光谱识别分子结构任务演示
书生·元征为科学智能打开自进化的崭新空间,它不局限于多模态感知能力的扩充,而是让模型得以自主优化科学感知架构。未来,上海AI实验室还将继续推进这套自进化科学感知体系的迭代,不断拓宽科学数据接入边界,落地于更多前沿科研场景,和生态伙伴一道,探寻科学智能自主探索之路,推动基础科学原始创新突破。