

司南评测新发现:大模型还无法真正改造蛋白质,“通专融合” 是突破关键
来源:上海人工智能实验室| 2026-10-30
蛋白质改造是科学智能落地生命科学的核心场景之一,国内外相关成果不断涌现:上海AI实验室先后推出蛋白质基座模型书生AMix-1、书生AMix-2,在蛋白质理解与设计任务上达到领先水平;海外大模型也陆续产出经湿实验验证的蛋白设计成果,新酶、蛋白结合体、细胞重编程因子相继问世。
为科学丈量AI在蛋白质改造任务上的能力边界,近日,上海AI实验室联合清华大学智能产业研究院(AIR)及清华大学药学院,共同推出专业蛋白质改造评测基准PFArena。
作为司南开放评测体系在科学智能方向的新进展,PFArena基于202项真实蛋白质实验,系统评测专业蛋白质模型、通用大模型与科学智能体的候选生成、排序及实验信息利用能力,并进一步探索实验反馈如何提升突变发现效率。
评测证实,现有大模型难以可靠完成蛋白质改造,再次印证了周伯文主任此前提出的“一冷一热”前沿洞察,即AI编程能力越来越强,但科研能力进展缓慢;“通专融合”是破局关键,通过协同通用与专业蛋白模型,打造具备假设生成、实验遴选、反馈迭代能力的闭环智能系统,可更好地支撑蛋白质改造与新功能挖掘。
技术报告:https://arxiv.org/abs/2609.28921
GitHub链接:https://github.com/AMix-Bio/PFArena
Hugging Face链接:https://huggingface.co/datasets/AMix-Bio/PFArena
·评测结果显示
蛋白质改造仍然很难,在实验资源有限、高阶突变组合的条件下挑战更大。即便是表现最优的模型,在仅允许输出40个候选的约束下,平均仅能命中不到2个高分突变,且模型表现会随突变复杂度升高同步下降。
蛋白质语言模型与通用大模型各有所长,互补潜力明显。缺少实验数据时,蛋白质语言模型更擅长挖掘优质突变;在获取实验信息后,通用大模型与智能体的优势更为突出。两类模型倾向捕获不同类型的有效突变,适合协同开展蛋白质改造。
实验反馈能显著提升大模型发现优质突变的能力。在总候选预算同为40个的条件下,依托逐轮实验反馈迭代,GPT-6 Astra的优质突变召回率从2.54%提升至4.65%。相比一次性给出答案,让模型根据实验结果不断调整决策,可能是更有潜力的方向。
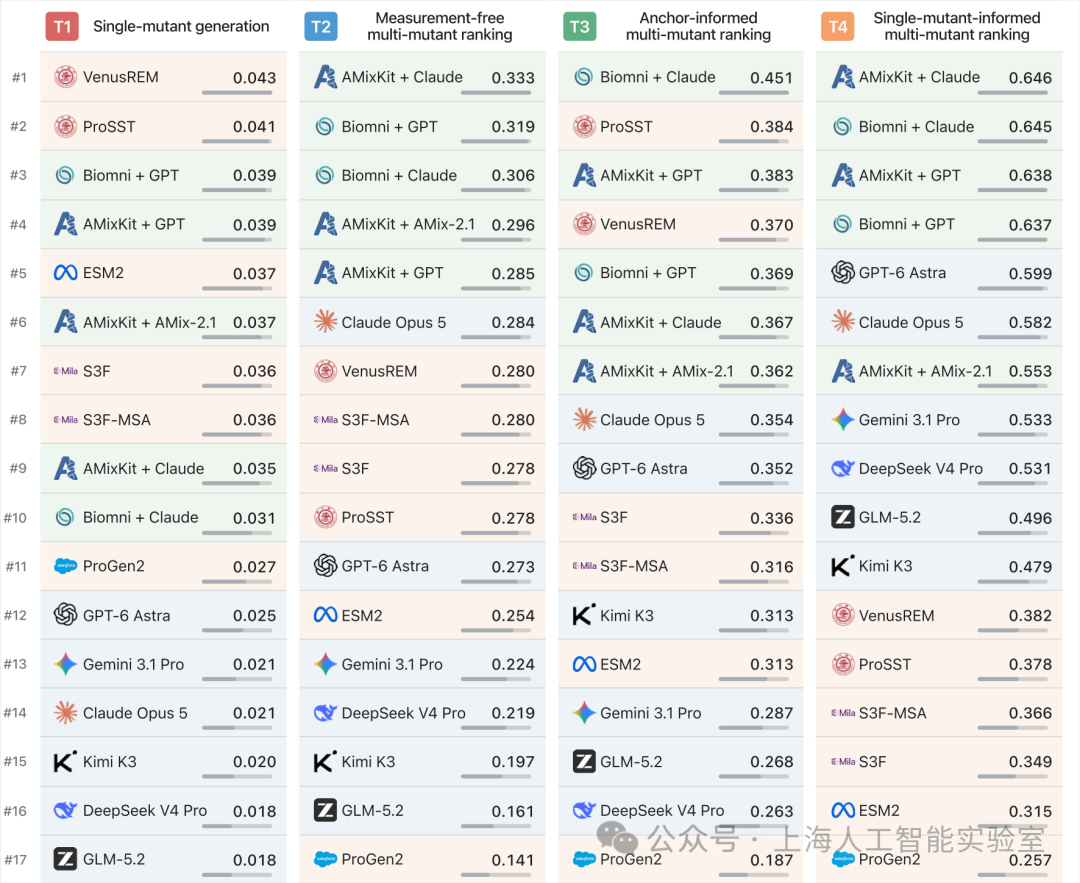
生成任务按召回率(Recall) 排名,排序任务按斯皮尔曼相关系数(Spearman)排名。指标结果详见论文
为什么需要PFArena?仅读懂蛋白不足以完成可靠改造
蛋白质改造的核心挑战,是在规模庞大的突变组合空间内,用有限的实验资源,筛选出活性、稳定性或特异性更优的蛋白。单点、单次的成功设计,不足以证明模型可以稳定可靠地支撑蛋白质改造工程。
想要厘清大模型距离落地实用的真实差距,需要依次回答三个层层递进的核心问题。其一,大模型能否真正读懂蛋白质,能否把握序列、结构与功能的内在关联,精准预判复杂突变组合带来的效果;其二,读懂蛋白质之后,大模型能否进一步支撑实验决策,在有限实验预算约束下自主提出高潜力突变候选,依托已有实验数据做出合理判断;其三,大模型能否实现闭环迭代,根据每一轮实测反馈动态调整搜索策略,持续发掘性能更优的突变。
这一递进链条,正是从读懂蛋白到读懂实验的分界。其中评判的重点,不只看模型能不能预测突变结果,更看它能否把蛋白质领域先验知识,转化为真实实验约束之下的有效决策。但当前多数蛋白质改造评测基准仍聚焦突变效应预测,仅能验证模型识读蛋白的能力,难以衡量其理解实验的水平。
为此,联合团队推出专业蛋白质改造评测基准PFArena。它跳出静态突变打分的传统范式,依托202项真实蛋白质实验,将评测范围拓展到不同实验信息条件下的候选生成与排序任务,面向蛋白质语言模型、通用大语言模型、科学智能体,搭建统一、可复现的对比框架,系统检验模型的候选生成、排序、实验信息复用能力,同时探究实验反馈对突变挖掘效率的增益效果,以此客观衡量模型读懂实验的水平。
PFArena做了什么?把真实蛋白质改造场景转化为可评测的任务
具体而言,PFArena将读懂实验落实为四类可比较的任务(T1-T4),覆盖生成什么突变和优先测试哪些候选两大核心,并清晰界定模型可获取的信息边界与输出要求。
T1单点突变生成:给定原始(野生型)蛋白质序列和实验目标,提供该蛋白任何突变测量数据,要求模型在全部合法单点突变空间中输出有限候选,考察模型的初始探索能力。
T2无实验信息的多点突变排序:给定一组多点突变候选,无任何突变效应实测数据,检验模型对突变组合的零样本判别能力。
T3锚点驱动的多点突变排序:提供一组已完成测定的突变体及其适应度,要求模型在该突变背景下对后续突变组合排序,考察模型利用已有实验锚点开展推理的能力
T4单点实验信息驱动的多点突变排序:给出候选组合内相关单点突变的实测结果,由模型预判多点组合的表现,衡量单点实测证据支撑多点突变决策的上限。
上述四项任务,从无实验信息到有较充分目标特异性数据全链路,对应实验室蛋白改造流程的不同阶段。
此外,PFArena基于真实实验测定的蛋白质适应度景观构建,汇集ProteinGym、MaveDB、MegaScale、FLAb、Human Domainome、CombinGym及人工整理的DMS研究。经过统一突变表示、实验分数方向校准和严格质量控制,基准最终包含202个独立实验(assays),293个任务实例,共60万余条目标候选记录,覆盖稳定性、结合、活性及细胞或个体功能等研究目标。
基于PFArena,研究团队系统评估了6种蛋白质语言模型(PLM)、6种通用大语言模型,以及基于Biomni和AMixKit构建的5种智能体组合,并从整体排序、头部排序、最佳候选发现和高适应度候选覆盖等维度进行评测。
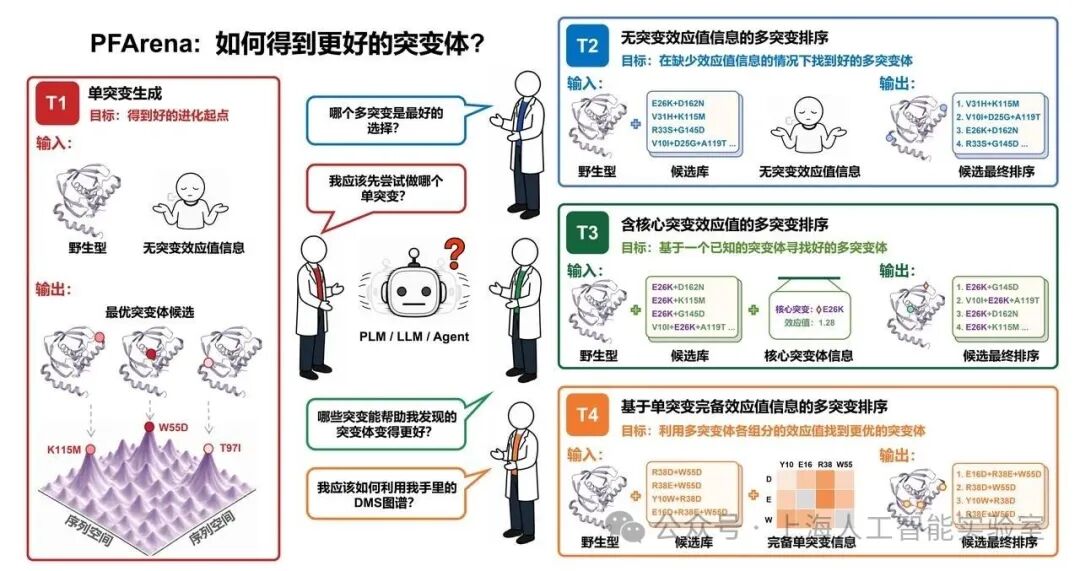
PFArena从实验科学家的视角评估蛋白质改造能力
评测揭示:大模型还无法真正改造蛋白质
依托PFArena基准开展大规模对照评测,科研团队清晰划定了当前AI技术在蛋白改造任务上的能力边界。整体而言,在T1至T4四项递进任务中,模型的相对表现随可获取的实验信息发生明显变化,不存在在全部场景下都占优的模型。
其中,在零目标特异性实测数据的T1单点突变生成任务中,蛋白质语言模型整体召回表现更突出,VenusREM在 Recall@40指标上为所有受试模型里最高,但整体绝对值依然偏低,高分突变找回难度很大;同时它的NMS@40仅小幅高于随机基线,说明高指标并不等同于稳定找到大量优质突变。
进入T2无实测信息多点排序任务,随着突变组合复杂度上升,所有模型的排序能力同步衰减,各类模型之间差距被压缩。
到了T3、T4阶段,当有部分实测锚点、单点突变实验结果可供模型使用时,通用大语言模型以及依托AMixKit搭建的科学智能体的优势逐步显现,更擅长利用已有的实验证据推理、判断多点突变组合的效果。
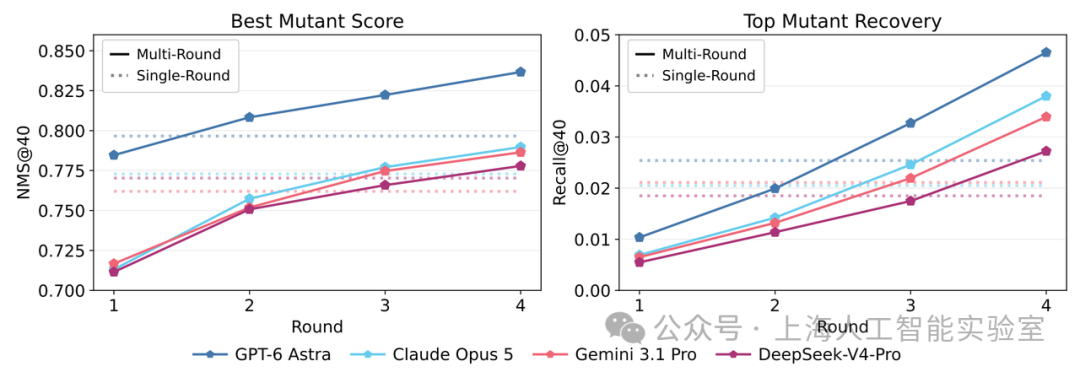
基于逐轮实验反馈的单点突变生成累计性能对比
此前,周伯文主任在2026年世界人工智能大会主论坛,分享了当前AI行业“一冷一热”前沿洞察:过去近一年,大模型在编程任务上的成功率大幅提升,但是科学任务完成率确进展缓慢。本次评测结果,进一步从蛋白质改造层面验证了这一观点。
从评测到实践:以“通专融合”打造蛋白质改造智能体系统
PFArena的评测结果,也印证了“通专融合”的核心价值。蛋白质语言模型承载序列、结构和进化层面的专业先验,通用大模型擅长理解科研目标、基于实验信息做多步分析,二者结合可以形成“1+1>2”的效果。
为了推动二者更高效地协同,团队开发了面向蛋白质改造的轻量化工具集AMixKit,使通用大模型能够调用专业蛋白质分析工具、整合外部信息,并通过多步骤推理完成候选评估与排序。评测数据显示,搭配该工具集的书生AMix-2.1,在四项任务中均展现出较强竞争力,为构建高性能、可部署的蛋白质改造智能体提供了新的可能。
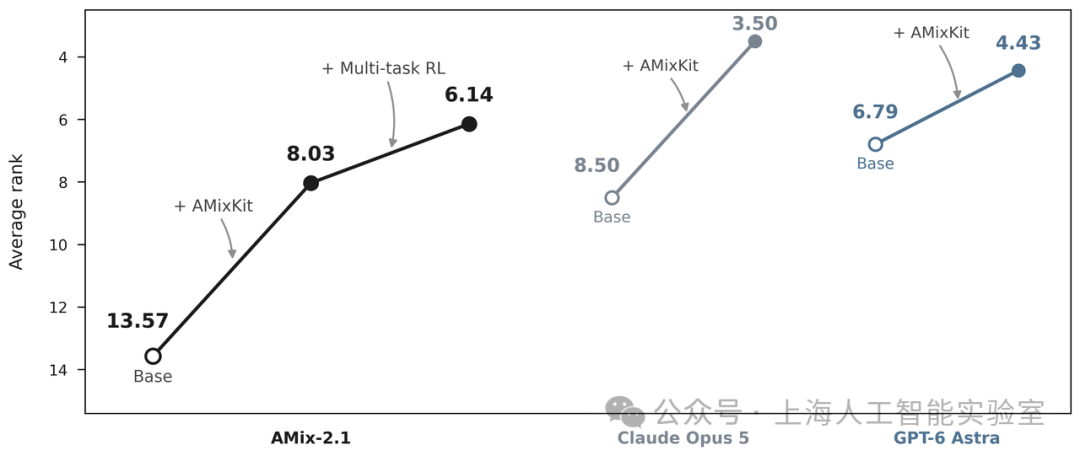
AMixKit与多任务强化学习带来的平均排名提升
基于PFArena揭示的能力瓶颈,科研人员进一步提出面向自主进化的蛋白质AI的三大重点方向。一是跳出单点突变与简单加性假设,理解复杂适应度景观,提升对高阶突变、非加性效应的预测能力;二是跳出单次静态预测,建立实验反馈驱动的闭环优化,在有限预算下评估多轮迭代带来的收益;三是打破单一模型范式,统筹专业先验、通用推理、工具调用与实验反馈,构建可自主提出假设、遴选实验、动态调整策略的协同系统。
从读懂蛋白到读懂实验,再到提出假设、设计实验并依据证据修正假设,是AI从知识工具走向科研伙伴的重要一步。PFArena将持续推动这一进程,让模型能力在真实实验约束下转化为有效的科学探索能力。